


Une API fonctionne correctement en développement. En production, le nombre de requêtes augmente, la mémoire monte, certaines lectures ralentissent et quelques transactions finissent en deadlock.
EF Core apparaît naturellement dans les traces. Le framework ajoute bien un coût autour des accès aux données, mais ce coût vient souvent de plusieurs mécanismes qui s’additionnent : suivi d’entités inutile, trop d’allers-retours SQL, création répétée des contextes ou transactions qui gardent des verrous plus longtemps que prévu. Microsoft rappelle d’ailleurs que, dans beaucoup d’applications réelles, le coût du réseau et du moteur SQL domine celui du runtime EF lui-même.
Le Change Tracker travaille même quand on ne modifie rien
Par défaut, une requête retournant des entités est suivie par le DbContext.
var portfolios = await dbContext.Portfolios .Where(x => x.Status == PortfolioStatus.Active) .ToListAsync(cancellationToken);
EF Core conserve alors les entités dans son Change Tracker afin de détecter les modifications lors d’un futur SaveChanges.
Pour une lecture destinée à alimenter une API, ce travail n’est souvent pas nécessaire.
var portfolios = await dbContext.Portfolios .AsNoTracking() .Where(x => x.Status == PortfolioStatus.Active) .Select(x => new PortfolioDto( x.Id, x.Name, x.Exposure)) .ToListAsync(cancellationToken);
AsNoTracking() évite l’enregistrement des entités dans le Change Tracker. La projection limite aussi les colonnes réellement ramenées depuis SQL.
Il faut cependant éviter d’en faire une règle absolue. Une requête suivie peut réutiliser une instance déjà présente dans le contexte grâce à l’identity resolution. Dans certains scénarios, cela réduit même le nombre d’objets instanciés. Le choix dépend donc de la durée de vie du contexte et de ce que l’on fera réellement des données.
Le N+1 coûte surtout des allers-retours
Le problème devient beaucoup plus visible lorsqu’une boucle déclenche implicitement des requêtes supplémentaires.
var portfolios = await dbContext.Portfolios .ToListAsync(cancellationToken);foreach (var portfolio in portfolios){ foreach (var position in portfolio.Positions) { Process(position); }}
Avec du lazy loading, l’accès à Positions peut provoquer une requête supplémentaire pour chaque portefeuille.
On obtient alors une première requête pour charger les portefeuilles, puis une série de requêtes supplémentaires.
1 requête Portfolio+ N requêtes Position
Sous charge, le coût vient surtout des allers-retours vers la base.
Lorsque les données sont connues à l’avance, je préfère rendre la requête explicite :
var portfolios = await dbContext.Portfolios .AsNoTracking() .Select(p => new { p.Id, Positions = p.Positions .Select(x => new { x.Id, x.Exposure }) .ToList() }) .ToListAsync(cancellationToken);
La projection permet de contrôler précisément ce qui quitte SQL Server. Microsoft recommande également de rester prudent avec le lazy loading, justement parce qu’il rend le N+1 particulièrement facile à introduire.
Un Include massif peut créer le problème inverse : multiplication des lignes lors de plusieurs jointures sur des collections. AsSplitQuery() peut alors être intéressant, avec le coût de plusieurs requêtes SQL distinctes.
Pooler les DbContext lorsque leur création devient mesurable
Un DbContext reste relativement léger. Sa création nécessite tout de même l’initialisation de plusieurs structures internes.
Sur une API très sollicitée, EF Core permet de réutiliser des instances :
services.AddDbContextPool<ApplicationDbContext>( options => { options.UseSqlServer(connectionString); });
Le contexte est réinitialisé puis replacé dans un pool lorsqu’il est rendu.
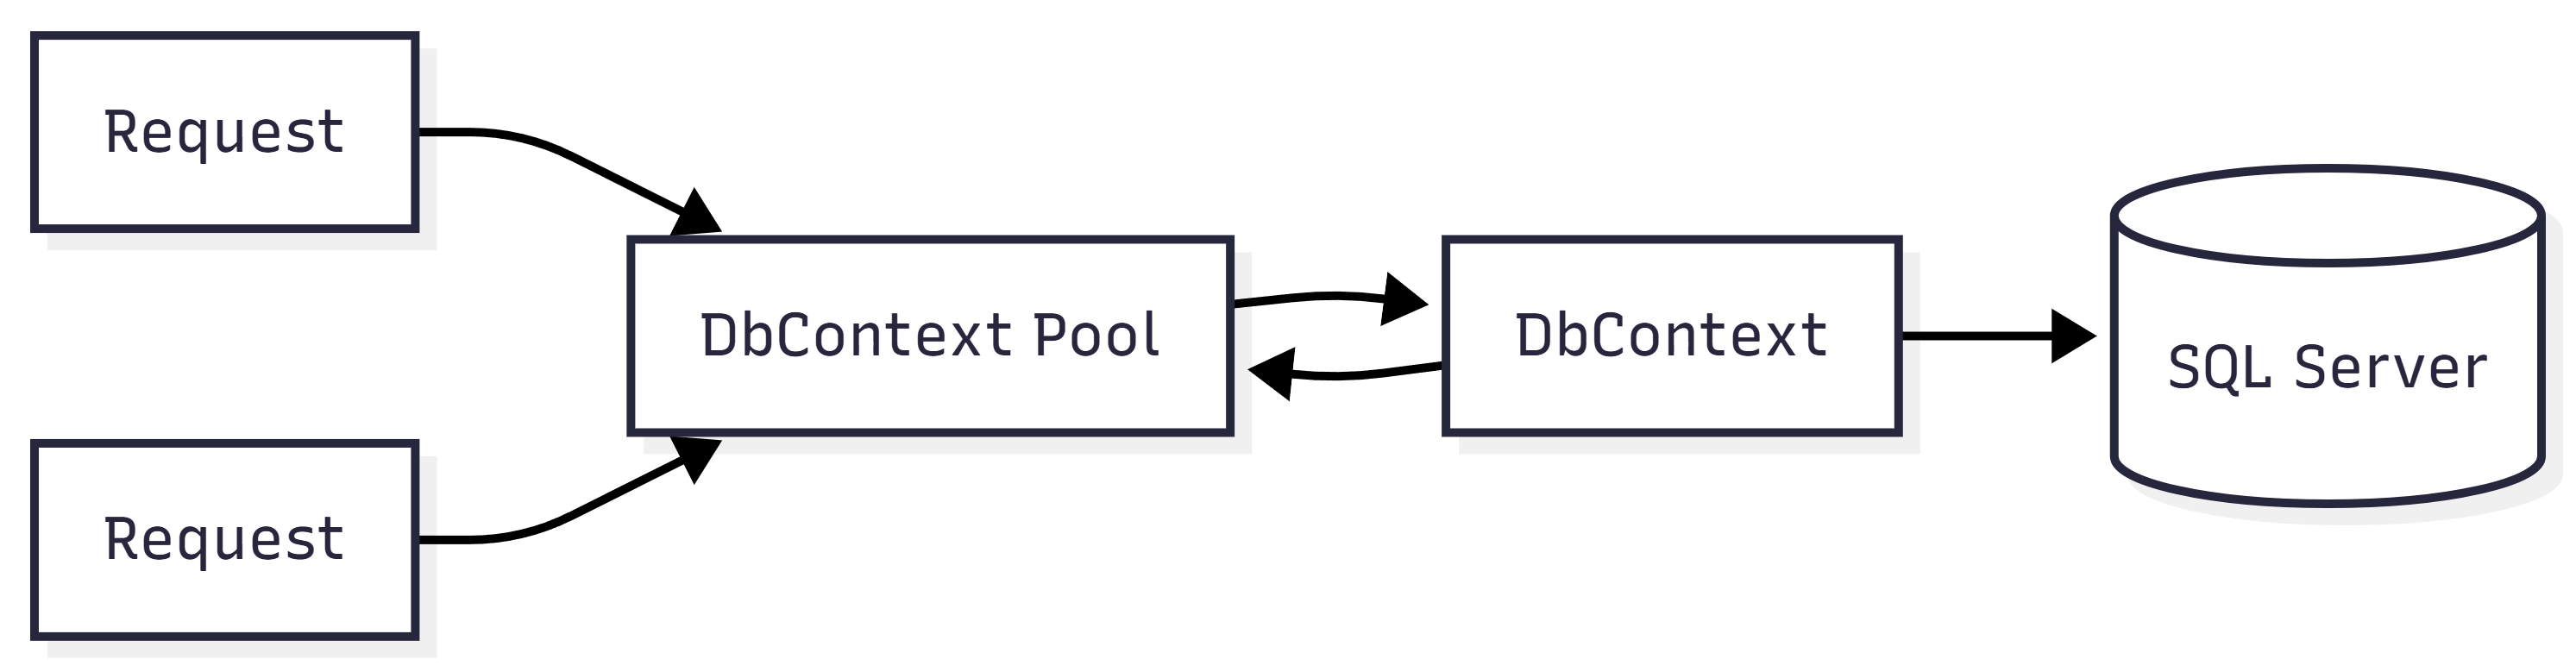
Ce pooling concerne le DbContext. Il ne remplace pas le connection pooling du provider SQL, qui fonctionne à un autre niveau.
Il faut aussi faire attention aux données d’état stockées dans le contexte. Un contexte poolé peut être réutilisé par une autre requête, ce qui rend les propriétés liées à un utilisateur, un tenant ou un traitement particulièrement sensibles.
Microsoft présente le pooling comme une optimisation destinée aux scénarios où le coût de création du contexte devient significatif. Il mérite donc d’être benchmarké avant d’être ajouté systématiquement.
Une requête LINQ possède elle aussi un coût de préparation
Avant son exécution, EF Core analyse l’arbre d’expression LINQ, trouve une requête équivalente dans son cache interne puis produit le SQL nécessaire.
Ce travail est déjà mis en cache.
Pour une requête très fréquente, on peut éliminer une partie de cette recherche avec une requête compilée explicitement.
private static readonly Func< ApplicationDbContext, int, IAsyncEnumerable<Position>> PositionsByPortfolio = EF.CompileAsyncQuery( (ApplicationDbContext db, int portfolioId) => db.Positions .AsNoTracking() .Where(x => x.PortfolioId == portfolioId));
Puis :
await foreach (var position in PositionsByPortfolio(dbContext, portfolioId)){ Process(position);}
L’intérêt apparaît surtout sur des requêtes exécutées très fréquemment et dont le coût SQL est déjà faible.
Si la requête prend 200 ms côté base, gagner quelques microsecondes sur sa préparation ne modifiera quasiment rien. Microsoft recommande justement de benchmarker ces scénarios avant d’utiliser EF.CompileQuery ou EF.CompileAsyncQuery.
Quand le problème quitte EF Core et arrive dans SQL Server
Une transaction trop large finit par conserver des verrous plus longtemps.
await using var transaction = await dbContext.Database.BeginTransactionAsync( cancellationToken);var portfolio = await dbContext.Portfolios .SingleAsync( x => x.Id == portfolioId, cancellationToken);portfolio.Exposure = CalculateExposure(portfolio);await externalRiskService.NotifyAsync( portfolio, cancellationToken);await dbContext.SaveChangesAsync(cancellationToken);await transaction.CommitAsync(cancellationToken);
L’appel réseau est ici réalisé pendant que la transaction est ouverte.
Si SQL Server conserve des verrous sur les ressources concernées, leur durée de vie inclut maintenant la latence du service externe.
Je préfère calculer et appeler les systèmes externes avant d’ouvrir la transaction lorsque le modèle métier le permet, puis garder la partie transactionnelle très courte.
EF Core crée déjà automatiquement une transaction autour d’un SaveChanges lorsque le provider en a besoin. Une transaction manuelle devient utile lorsque plusieurs opérations doivent réellement partager la même atomicité.
Les compiled models jouent sur le démarrage
Les compiled models répondent à un autre coût que les requêtes compilées. EF Core doit construire son modèle à partir des entités, relations et configurations lors de la première utilisation du DbContext. Sur un modèle comportant plusieurs centaines de types, ce temps d’initialisation peut devenir visible.
dotnet ef dbcontext optimize
La commande génère une représentation compilée du modèle qui peut ensuite être utilisée directement par le contexte. Microsoft réserve surtout cette optimisation aux modèles volumineux dont le temps de première utilisation est réellement problématique ; sur un modèle classique, le gain ne justifie généralement pas la complexité supplémentaire. Le modèle généré doit aussi être régénéré lorsque sa définition change.
ExecuteUpdate évite de matérialiser pour modifier
Certaines mises à jour n’ont aucune raison de charger les entités en mémoire.
var positions = await dbContext.Positions .Where(x => x.Status == PositionStatus.Pending) .ToListAsync();foreach (var position in positions){ position.Status = PositionStatus.Processed;}await dbContext.SaveChangesAsync();
Depuis EF Core 7, ExecuteUpdate permet d’envoyer directement l’opération au moteur SQL.
await dbContext.Positions .Where(x => x.Status == PositionStatus.Pending) .ExecuteUpdateAsync( update => update.SetProperty( x => x.Status, PositionStatus.Processed));
EF Core génère ici une commande UPDATE unique. Les entités ne sont ni matérialisées ni suivies par le Change Tracker. ExecuteDelete suit le même principe pour les suppressions. Ces opérations s’exécutent immédiatement et ne passent pas par SaveChanges, ce qui compte lorsqu’elles doivent participer à une transaction avec d’autres modifications.
Quand SaveChanges n’est plus adapté au volume
SaveChanges sait déjà regrouper plusieurs commandes SQL dans un même aller-retour. Pour SQL Server, EF Core limite par défaut la taille des batches et ajuste ce comportement au provider. Cela reste une succession d’INSERT, d’UPDATE ou de DELETE individuels côté base.
Lorsqu’un batch doit insérer plusieurs centaines de milliers de lignes, une véritable opération de bulk peut devenir plus adaptée. EF Core ne fournit pas une abstraction native universelle de type BulkInsert comparable à ExecuteUpdate. Avec SQL Server, SqlBulkCopy permet par exemple d’envoyer efficacement un flux de lignes directement vers une table.
await using var bulkCopy = new SqlBulkCopy(connection);bulkCopy.DestinationTableName = "dbo.Positions";bulkCopy.BatchSize = 10_000;await bulkCopy.WriteToServerAsync(reader);
À ce niveau, on quitte volontairement une partie de l’abstraction EF Core pour utiliser une capacité spécifique du provider. Des bibliothèques spécialisées proposent également des API bulk autour d’EF Core. Leur intérêt apparaît surtout lorsque le volume rend le coût du Change Tracker et des commandes unitaires réellement mesurable.
Le pool de connexions peut devenir la limite
Le pooling du DbContext et celui des connexions SQL sont deux mécanismes indépendants. AddDbContextPool réutilise des instances de contexte. Microsoft.Data.SqlClient maintient de son côté des connexions physiques ouvertes et les réattribue lorsqu’un SqlConnection est demandé.
Pour une chaîne de connexion donnée, le pool possède notamment une taille maximale. Avec SqlClient, sa valeur par défaut est actuellement de 100 connexions. Lorsque toutes sont occupées, les demandes suivantes attendent qu’une connexion revienne dans le pool, jusqu’au timeout.
Server=sql01;Database=Risk;Integrated Security=true;Max Pool Size=200;Min Pool Size=10;
Augmenter Max Pool Size ne constitue pas une correction automatique. Deux cents connexions concurrentes peuvent simplement déplacer la saturation vers SQL Server. Avant de toucher à cette valeur, je regarde le temps pendant lequel les connexions restent occupées, les transactions ouvertes, le nombre de requêtes concurrentes et la capacité réelle de la base.
Une connexion prise dans le pool puis conservée pendant une transaction lente réduit directement la capacité disponible pour les autres requêtes. Le tuning commence donc souvent par raccourcir la durée d’utilisation des connexions avant d’augmenter le pool.
Un deadlock reste un problème SQL
Deux requêtes EF Core peuvent parfaitement provoquer un deadlock.
Transaction Averrouille Portfolio | vattend PositionTransaction Bverrouille Position | vattend Portfolio
EF Core produit les commandes. SQL Server prend les verrous et détecte le cycle.
Les causes intéressantes se trouvent souvent dans l’ordre d’accès aux tables, la durée des transactions, les index et le volume de lignes concernées.
Changer le code LINQ sans regarder le SQL produit risque donc de déplacer le problème sans comprendre ce qui se passe réellement.
Dans ce type d’incident, j’analyse la commande SQL générée, le plan d’exécution et le deadlock graph côté SQL Server. Le niveau d’isolation compte également : certains niveaux conservent davantage de verrous, alors que les approches basées sur le snapshot déplacent une partie de la gestion de concurrence vers le versioning des lignes.
Sous charge, je commence par compter les accès SQL
Avant de toucher au pooling ou aux requêtes compilées, je cherche généralement combien de requêtes sont réellement exécutées et combien de temps elles prennent.
Une API lente peut cacher un N+1. Une consommation mémoire élevée peut provenir de milliers d’entités suivies alors qu’elles sont uniquement lues. Une requête LINQ apparemment correcte peut produire un SQL coûteux. Un endpoint dont la latence varie fortement peut attendre des verrous.
Le logging EF Core, Application Insights, OpenTelemetry, SQL Server Query Store et les outils de profiling donnent rapidement une image beaucoup plus fiable.
À ce stade, AsNoTracking, le pooling ou une requête compilée deviennent des réponses à un problème mesuré.
C’est là qu’EF Core commence réellement à être optimisé.


 Xavier Raboteur
