


Une API ASP.NET Core répond correctement avec quelques utilisateurs. Sous charge, la latence augmente brutalement alors que le CPU reste loin de 100 %.
Ce comportement peut venir du ThreadPool.
.NET utilise un pool de threads pour exécuter une grande partie du travail applicatif : tâches TPL, callbacks, timers, certaines continuations et traitements associés aux entrées/sorties asynchrones. Le runtime ajuste lui-même le nombre de threads afin de rechercher un bon débit sans créer inutilement des centaines de threads.
Comprendre ce mécanisme permet surtout d’éviter un problème fréquent sur les applications serveur : la ThreadPool starvation.
Le ThreadPool évite de créer un thread pour chaque travail
Créer un thread possède un coût. Il faut notamment lui réserver une stack, le scheduler doit ensuite le gérer et les changements de contexte augmentent lorsque leur nombre devient important.
Le ThreadPool conserve donc un ensemble de worker threads réutilisables.
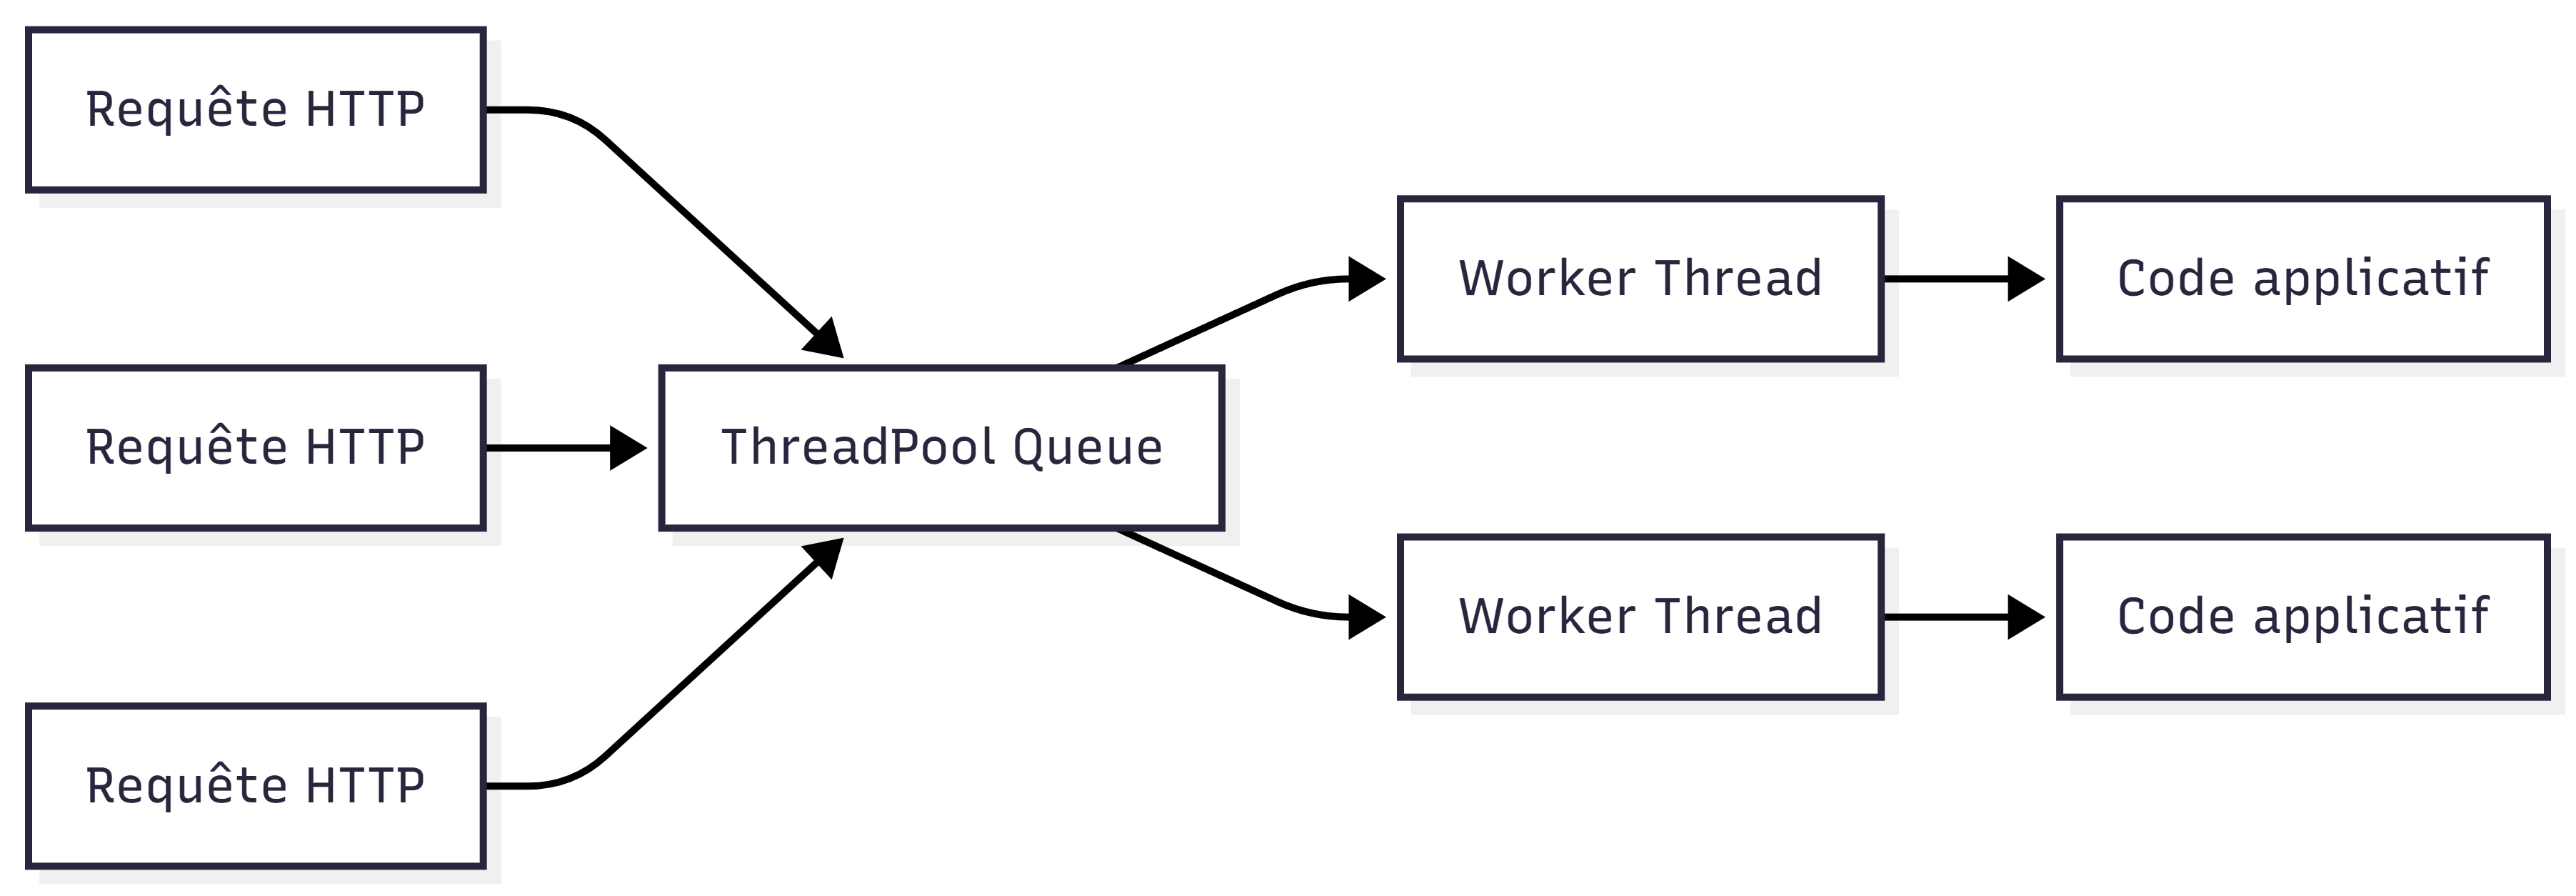
Lorsqu’un travail arrive, il peut être placé dans une file puis exécuté lorsqu’un worker devient disponible.
Le runtime fait varier la taille du pool selon la charge observée. Trop peu de threads laisseraient du travail attendre alors que la machine dispose encore de ressources. Un nombre excessif augmente la contention et le coût des changements de contexte.
Ce que async/await change réellement
Prenons une API qui interroge SQL Server.
public async Task<Customer?> GetCustomerAsync( int customerId, CancellationToken cancellationToken){ return await dbContext.Customers .FirstOrDefaultAsync( x => x.Id == customerId, cancellationToken);}
Pendant l’attente de la réponse SQL, le thread qui exécutait la méthode n’a pas besoin de rester bloqué.
Il peut retourner au pool et servir un autre travail.
Lorsque l’opération d’entrée/sortie se termine, la suite de la méthode devient exécutable et sera reprise selon le contexte d’exécution, fréquemment par un worker du ThreadPool dans une application ASP.NET Core.
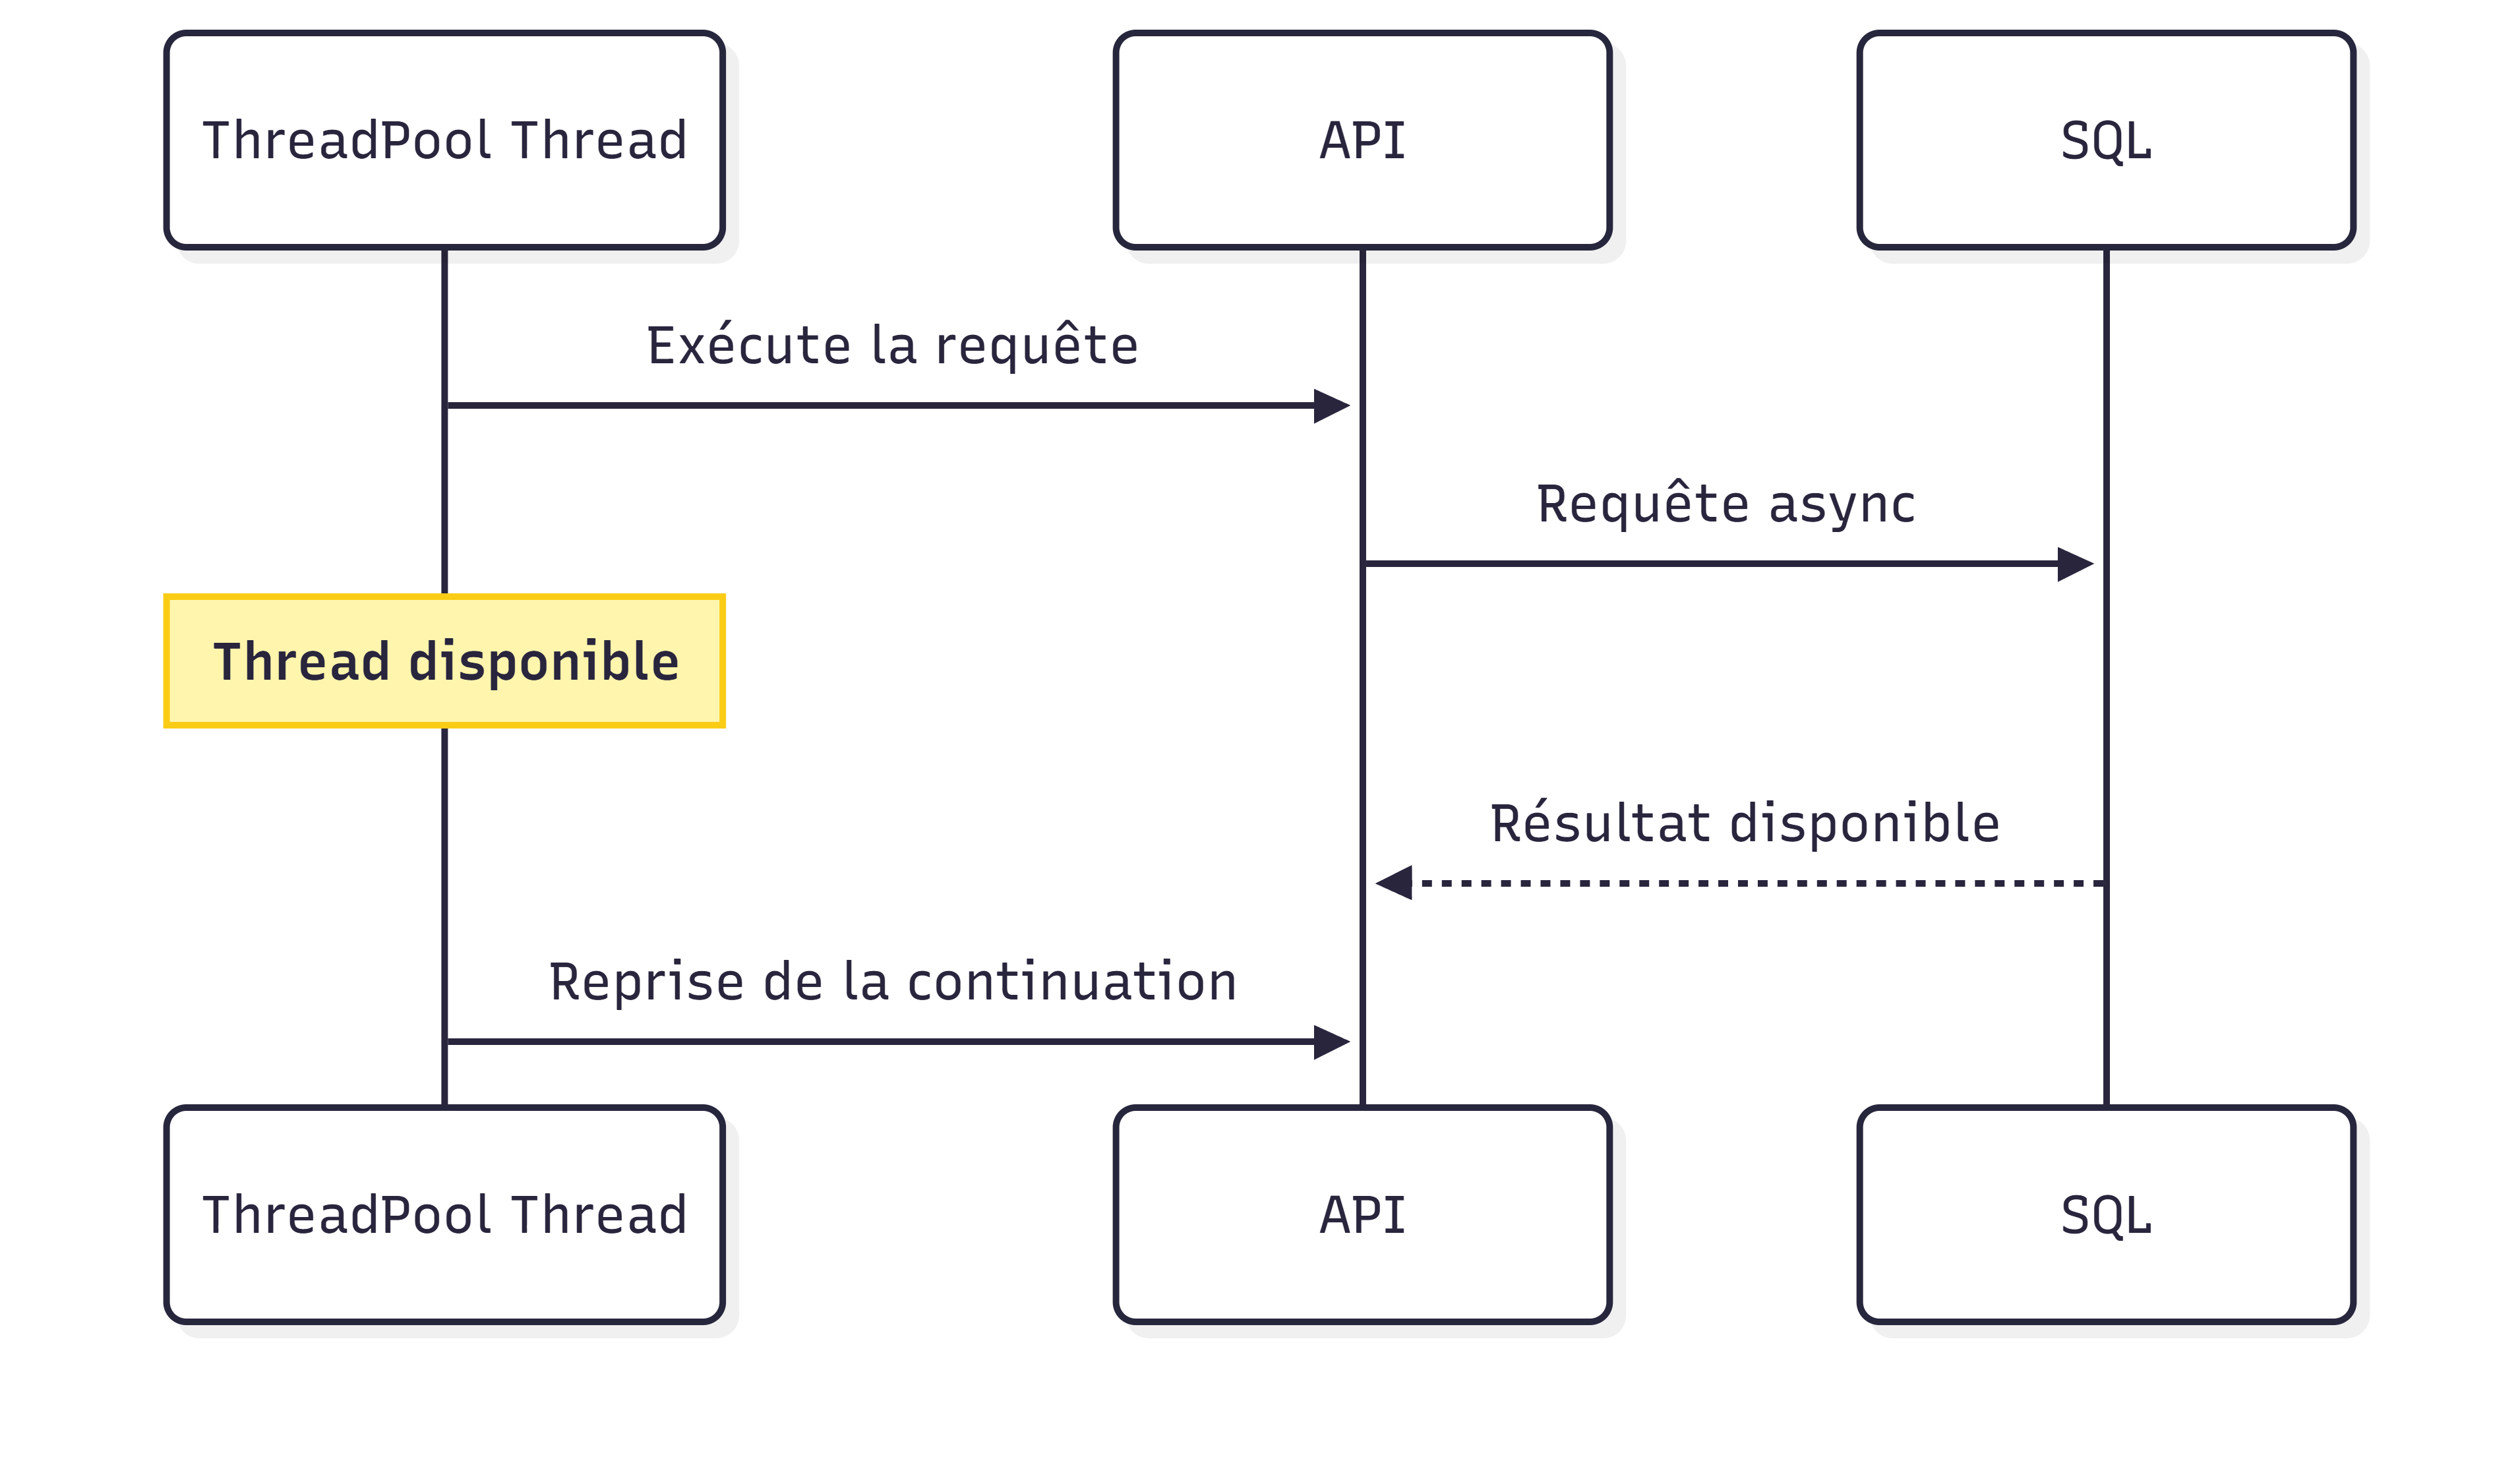
async/await permet ainsi à un nombre relativement contenu de threads de supporter beaucoup d’opérations concurrentes lorsque celles-ci passent une partie importante de leur temps à attendre des I/O. Microsoft recommande cette approche sur les hot paths ASP.NET Core afin d’éviter de bloquer les threads du pool.
Le problème du sync-over-async
Le comportement change avec ce code :
public Customer? GetCustomer(int customerId){ return repository .GetCustomerAsync(customerId) .Result;}
.Result bloque le thread courant en attendant la fin de la tâche.
Le worker reste donc occupé alors qu’il ne réalise aucun calcul utile.
La même situation apparaît avec :
task.Wait();
ou :
task.GetAwaiter().GetResult();
Quelques appels de ce type passent facilement inaperçus.
Sous forte concurrence, plusieurs dizaines de requêtes peuvent bloquer simultanément plusieurs dizaines de workers. Les nouveaux travaux continuent d’arriver dans la queue alors que le pool dispose de moins en moins de threads immédiatement disponibles.
C’est le début d’une starvation. Microsoft identifie justement le sync-over-async comme l’une des causes les plus fréquentes de ThreadPool starvation.
La version asynchrone conserve le thread disponible pendant l’I/O :
public async Task<Customer?> GetCustomerAsync( int customerId){ return await repository .GetCustomerAsync(customerId);}
La différence devient surtout visible sous charge.
Saturation CPU et starvation ne donnent pas les mêmes signaux
Un traitement CPU intensif peut utiliser tous les workers disponibles parce que les processeurs travaillent réellement.
Parallel.ForEach( portfolios, portfolio => CalculateRisk(portfolio));
Si tous les cœurs approchent 100 %, augmenter le nombre de threads ne donnera généralement pas davantage de capacité CPU.
Lors d’une ThreadPool starvation, le profil est souvent différent. Des travaux restent en attente, le nombre de threads du pool augmente progressivement et le CPU peut rester nettement sous les 100 %. Le runtime injecte de nouveaux threads afin de compenser ceux qui restent bloqués.
On peut résumer le comportement ainsi :
CPU élevé + travail actif ↓Charge CPU réelleQueue qui augmente + threads bloqués + CPU modéré ↓Starvation probable
Depuis .NET 6, le ThreadPool réagit plus rapidement à certaines formes de blocage associées aux API Task. Cela réduit la durée de certaines périodes de starvation, sans rendre les appels bloquants gratuits.
Task.Run ne rend pas une I/O asynchrone
On rencontre parfois ce type de correction :
var customer = await Task.Run( () => repository.GetCustomer(customerId));
Pour une opération synchrone bloquante, le travail a simplement été déplacé vers un autre thread du ThreadPool.
Le thread reste occupé pendant toute l’attente.
Dans une API ASP.NET Core, Task.Run suivi immédiatement d’un await ajoute également une étape de scheduling alors que le code applicatif s’exécute déjà sur le ThreadPool. Microsoft recommande donc d’utiliser directement les API asynchrones disponibles pour les accès réseau, fichiers ou base de données.
Task.Run garde son intérêt pour certains travaux CPU lorsqu’on souhaite explicitement les planifier sur le ThreadPool. Il ne transforme pas une API I/O synchrone en véritable API asynchrone.
Voir la starvation plutôt que la deviner
dotnet-counters donne rapidement une première lecture du processus.
dotnet-counters monitor -n MyApi
Parmi les métriques utiles :
dotnet.thread_pool.thread.countdotnet.thread_pool.queue.lengthdotnet.thread_pool.work_item.count
Une queue qui grossit accompagnée d’une augmentation régulière du nombre de threads mérite d’être examinée. L’utilisation CPU apporte un contexte supplémentaire.
Une fois le symptôme identifié, dotnet-stack, dotnet-trace ou un dump permettent d’observer ce que font réellement les workers.
Depuis .NET 9, l’événement WaitHandleWait facilite notamment l’identification des attentes provoquées par Task.Result, Task.Wait, lock, Monitor ou certaines attentes sur SemaphoreSlim.
Dans une application serveur, je cherche donc les threads bloqués avant de modifier la taille du ThreadPool.
Augmenter MinThreads peut parfois masquer temporairement le symptôme. Le runtime sait déjà faire évoluer son pool et Microsoft déconseille d’augmenter ces valeurs sans raison mesurée, car trop de threads peuvent eux-mêmes dégrader les performances.
Le point intéressant se trouve généralement dans le code qui retient les workers : appel synchrone vers une I/O, .Result, .Wait(), lock trop long ou traitement CPU lancé sans contrôle.
C’est ce chemin d’exécution qu’il faut profiler.


 Xavier Raboteur
