


Une méthode C# n’est pas exécutée directement par le processeur telle qu’elle apparaît dans Visual Studio.
Entre le code source et les instructions réellement exécutées, .NET introduit plusieurs étapes. Ce pipeline explique une partie du temps de démarrage d’une application, certaines optimisations observées après quelques secondes d’exécution et les différences entre une publication classique et Native AOT.
Comprendre ce chemin devient utile dès qu’on commence à profiler du code .NET.
Le compilateur C# produit de l’IL
Prenons une méthode très simple.
public static decimal CalculateExposure( decimal quantity, decimal price){ return quantity * price;}
Lors du build, le compilateur C# produit principalement du CIL, couramment appelé IL, accompagné des métadonnées nécessaires au runtime.
Le processeur x64 ou ARM64 ne sait pas exécuter directement cet IL. Une seconde compilation doit avoir lieu avant l’exécution. Dans une application .NET classique, cette responsabilité revient au JIT.

Cette étape intermédiaire donne à .NET une propriété intéressante : le même assembly IL peut être transformé en code natif adapté à l’architecture sur laquelle il s’exécute.
Le JIT compile ce qui est réellement exécuté
Le Just-In-Time compiler intervient lorsqu’une méthode doit être exécutée.
Il transforme son IL en instructions machine, puis le code natif obtenu reste disponible dans le processus pour les appels suivants. Une méthode qui n’est jamais appelée n’a donc pas besoin d’être compilée par le JIT.
Ce fonctionnement introduit nécessairement un coût lors des premières exécutions. Sur une API qui reste active pendant plusieurs jours, quelques millisecondes de compilation initiale ont généralement peu d’importance. Sur un processus très court, une Function fortement sollicitée à froid ou un outil CLI, ce coût devient plus visible.
Le JIT possède aussi une information que le compilateur C# n’avait pas au moment du build : il connaît l’architecture exacte sur laquelle le programme tourne.
Il peut alors produire du code adapté au processeur disponible.
Pourquoi une méthode peut être compilée deux fois
Compiler immédiatement chaque méthode avec le niveau maximal d’optimisation coûterait davantage au démarrage.
.NET utilise donc la Tiered Compilation.
Une méthode peut d’abord recevoir rapidement une première version de code natif. Si elle devient suffisamment utilisée, le runtime peut ensuite la recompiler en arrière-plan avec davantage d’optimisations. La compilation hiérarchisée fonctionne suivant ce principe depuis .NET Core 3.0, où elle est activée par défaut.
Le parcours ressemble alors davantage à ceci :
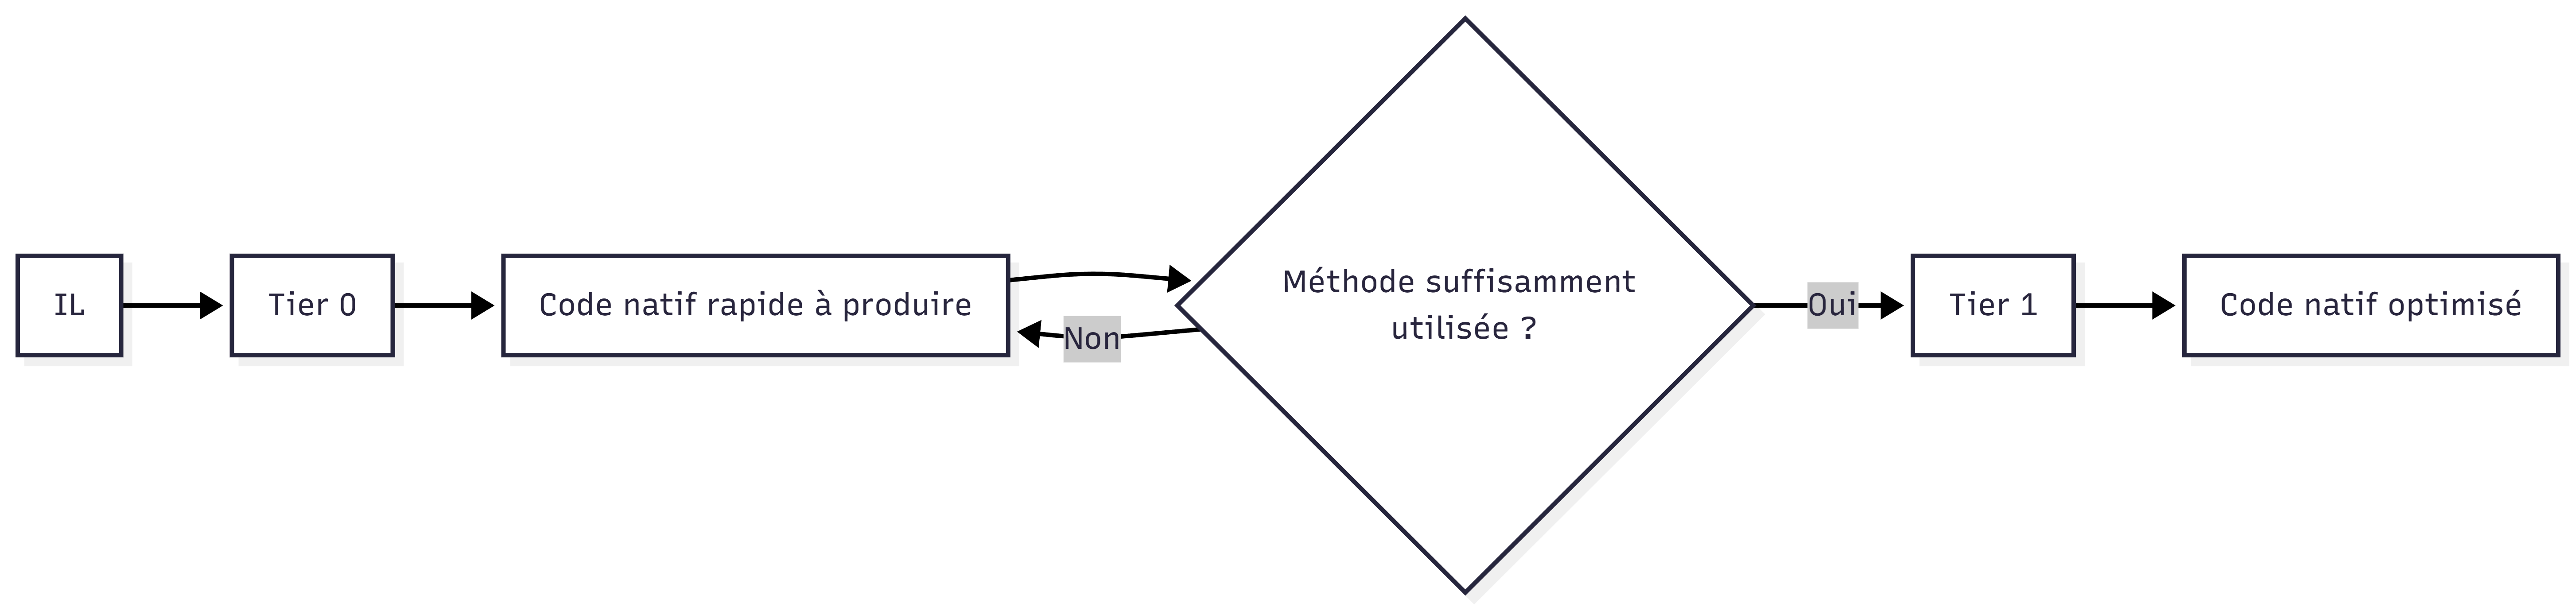
Cette mécanique permet de chercher un équilibre entre démarrage rapide et qualité du code généré après montée en charge.
Elle explique aussi pourquoi un microbenchmark lancé naïvement peut produire des résultats trompeurs. Les premières exécutions peuvent ne pas utiliser exactement le même code machine que celles effectuées après warm-up.
C’est l’une des raisons pour lesquelles j’utilise BenchmarkDotNet plutôt qu’un Stopwatch placé autour de quelques appels.
Le runtime peut aussi apprendre du code qui tourne
La Tiered Compilation peut travailler avec la Dynamic PGO, Profile-Guided Optimization.
Le runtime observe certains comportements du programme pendant son exécution et peut utiliser ces informations lorsqu’il génère une version optimisée d’une méthode. Une branche fréquemment empruntée ou les types réellement rencontrés pendant l’exécution peuvent ainsi influencer les optimisations produites.
On arrive alors à un comportement assez éloigné de l’idée d’une compilation figée une fois pour toutes.
IL | vpremière compilation | vobservation de l'exécution | vrecompilation optimisée
Le code machine d’une application .NET peut donc évoluer pendant la vie du processus.
Native AOT déplace la compilation avant l’exécution
Pour certains scénarios, on peut supprimer cette étape JIT à l’exécution.
Avec Native AOT, l’IL est compilé en code natif au moment de la publication.
<PropertyGroup> <PublishAot>true</PublishAot></PropertyGroup>
Puis :
dotnet publish -c Release -r linux-x64
Le résultat est une application autonome ciblant directement une plateforme et une architecture données.

À l’exécution, aucun compilateur JIT n’intervient. Microsoft met notamment en avant un démarrage plus rapide et une empreinte mémoire plus faible pour ce mode de publication. Native AOT est particulièrement intéressant pour les workloads comportant beaucoup d’instances ou des processus dont le temps de démarrage compte réellement.
Le compromis apparaît au moment où l’application dépend fortement du caractère dynamique de .NET.
Native AOT ne supporte pas la génération de code à l’exécution avec Reflection.Emit, limite certains usages du chargement dynamique d’assemblies et impose le trimming. Certaines bibliothèques doivent donc être adaptées ou annotées pour être correctement analysées lors de la publication.
JIT ou AOT dépend du cycle de vie du processus
Pour une API métier ASP.NET Core classique, le JIT et la Tiered Compilation fonctionnent très bien. Le processus reste longtemps actif et le runtime dispose du temps nécessaire pour optimiser les méthodes les plus utilisées.
Je regarderais Native AOT plus attentivement sur un outil CLI lancé des centaines de fois, une application serverless sensible au cold start ou un service déployé à très grande densité.
Le critère intéressant reste mesurable : temps de démarrage, consommation mémoire, taille du binaire et débit une fois l’application chaude.
Pour observer ce que le JIT produit réellement, BenchmarkDotNet permet également d’aller jusqu’au désassemblage du code généré. À ce niveau, une optimisation C# cesse d’être une intuition : on peut regarder les instructions que le processeur exécutera réellement.


 Xavier Raboteur
